
En el N100, OpenVINO no fue más rápido. Y estuve a punto de medirlo mal

Si trabajas con modelos en equipos Intel, conoces la recomendación habitual: para inferencia en CPU, OpenVINO. Es el runtime de Intel, hecho para su hardware, y en una mini PC con un N100 parecería la elección obvia frente a ONNX Runtime.
Lo medí. En el N100, con los tres modelos que comparé, OpenVINO fue entre un 11 % y un 22 % más lento que ONNX Runtime.
Pero lo interesante no es ese resultado. Es que antes de llegar a él estuve a punto de medir otra cosa, y la medición equivocada habría pasado todas las comprobaciones.
Lo que pasó en el ensayo
Antes de tocar el N100 ensayé el protocolo en mi Mac, que tiene una CPU ARM. MobileNetV2 en FP32, OpenVINO con su configuración por defecto.
Salió rápido, y salió bien: las salidas coincidían con la referencia. La misma clase ganadora en las doce imágenes de prueba, y una similitud de coseno de 0.999 o más contra el resultado esperado.
Luego miré algo que casi nadie mira: la precisión con la que OpenVINO había decidido ejecutar el modelo.
Un modelo en FP32, y OpenVINO ejecutándolo en FP16. Sin pedirlo y sin avisar.
INFERENCE_PRECISION_HINT = float16
Es una decisión de diseño de OpenVINO, no un error: en ese procesador, FP16 corre más rápido. Pero no es la que yo le pedí, y no aparece en ninguna parte a menos que la busques. Con FP16, el p50 del modelo fue de 1.46 ms. Forzando f32, el mismo modelo en el mismo equipo tardó 2.39 ms.
Si me hubiera quedado con el primer número, habría medido un cambio de precisión y se lo habría atribuido al runtime.
Por qué la validación no lo atrapa
Esto es lo que me parece importante de todo el asunto. La comprobación habitual —¿da las mismas respuestas?— pasó. Y tenía que pasar: para clasificar imágenes, FP16 alcanza. La salida no cambia lo suficiente para que una prueba de exactitud lo note.
Así que da los mismos resultados y va más rápido no prueba que la comparación sea justa. Prueba que el cambio de precisión fue lo bastante pequeño para no notarse en ese modelo. En otro —uno más profundo, uno de regresión, uno que ya viene cuantizado— a lo mejor sí se nota. Y a lo mejor se nota en producción.
Cómo lo medí en el N100
Después del ensayo, el protocolo cambió. En todo caso FP32, la precisión se fija en f32 al compilar el modelo, y después de compilarlo se lee la precisión efectiva. Si no es f32, la medición no cuenta: se marca como inválida, aunque haya pasado todo lo demás.
compiled = core.compile_model(model, "CPU", {"INFERENCE_PRECISION_HINT": "f32"})
compiled.get_property("INFERENCE_PRECISION_HINT")   # se comprueba, no se supone
Con eso, en un Intel N100 de 8 GB con Ubuntu 24.04, recién reiniciado, cien medidas tras veinte de calentamiento, batch 1 e hilos por defecto:
| Modelo | ONNX Runtime 1.30.0 | OpenVINO 2026.4.0 | OpenVINO frente a ORT |
|---|---|---|---|
| MobileNetV2 FP32 | 5.7 ms | 7.0 ms | 22 % más lento |
| ResNet18 FP32 | 22.8 ms | 26.8 ms | 18 % más lento |
| YOLO26n FP32 | 57.6 ms | 64.0 ms | 11 % más lento |
Son el p50 de la inferencia del modelo. La precisión efectiva de OpenVINO fue f32 en los tres casos, y en los tres las salidas coincidieron con la referencia. En la detección, el YOLO26n encontró los mismos objetos que la referencia, ni uno más ni uno menos.
No lo había predicho. Antes de medir escribí qué esperaba de cada caso, y en éste dejé la respuesta como incógnita. La medición la resolvió en una dirección que no esperaba.
No es ruido
El p50 es una sola cifra. Ésta es cada una de las cien inferencias de cada caso:
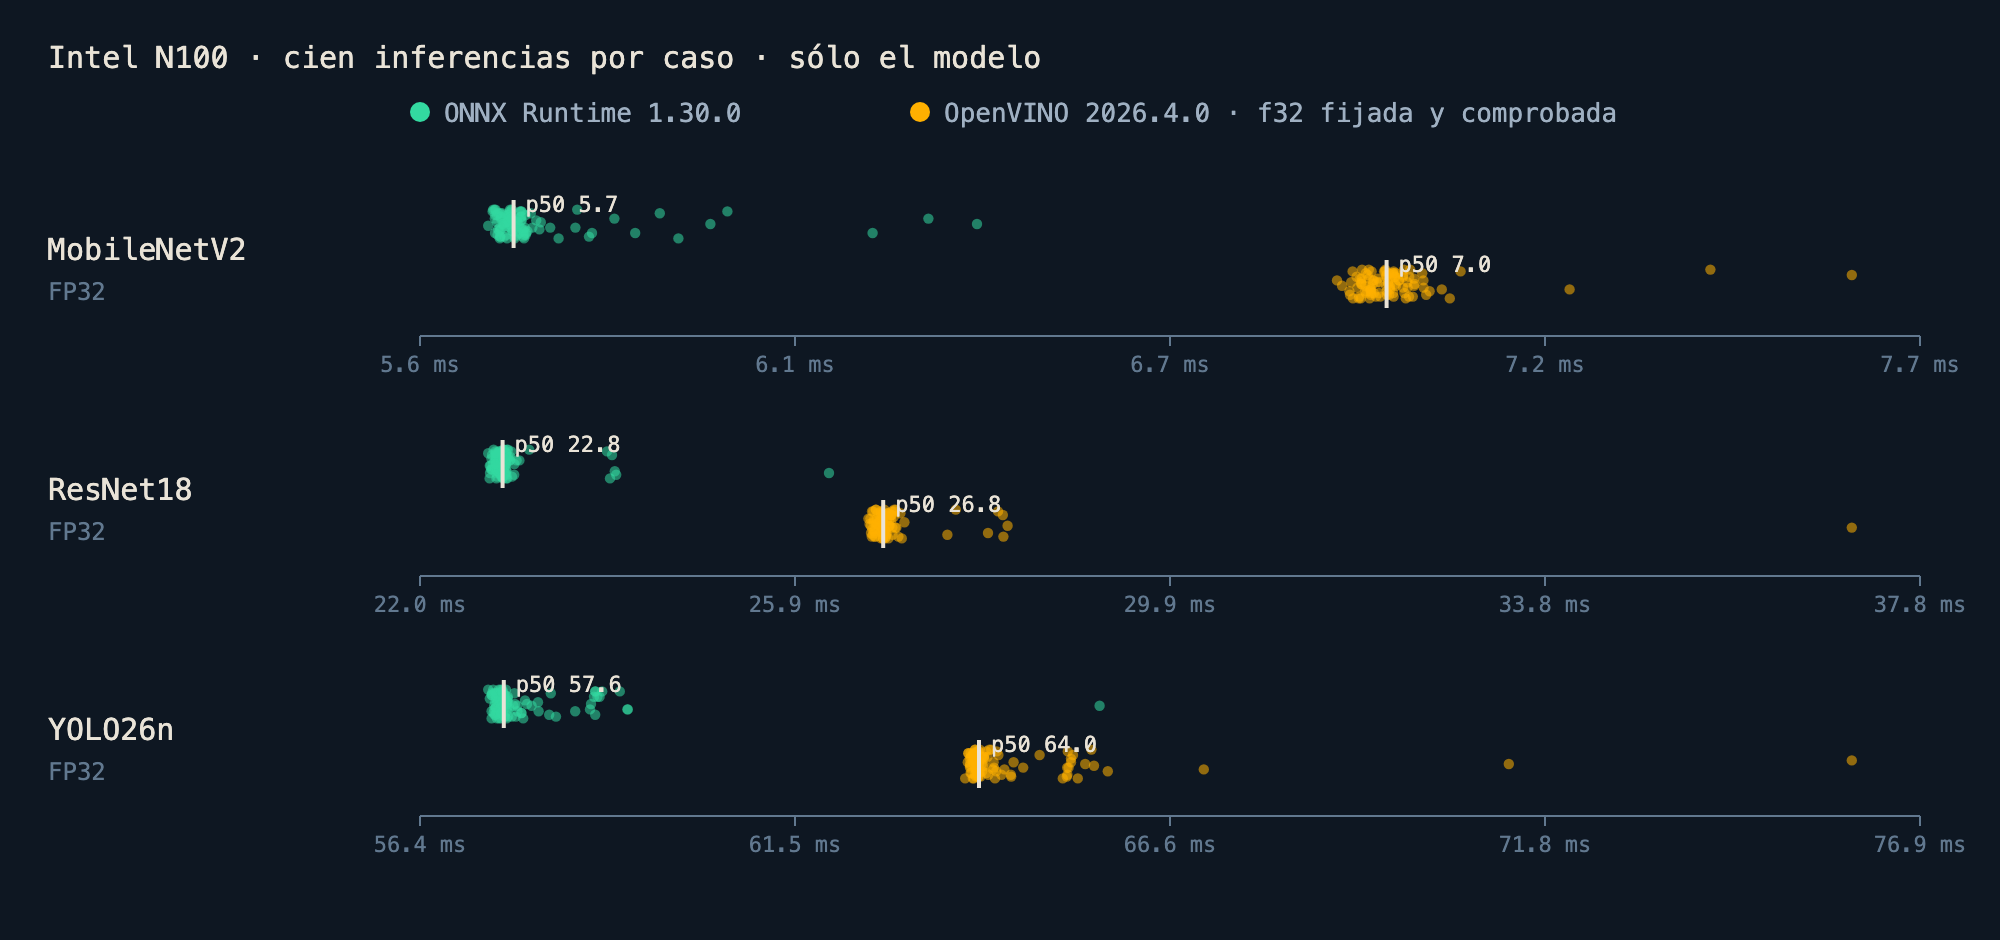
Las nubes no se tocan. Comparando cada inferencia de ONNX Runtime contra cada una de OpenVINO —diez mil pares por modelo—, ONNX Runtime fue más rápido en el 100 % de los pares con MobileNetV2 y con ResNet18, y en el 99 % con YOLO26n. En los dos primeros, la inferencia más lenta de ONNX Runtime fue más rápida que la más rápida de OpenVINO. La diferencia no es ruido de la medición: es sistemática.
Los datos crudos —cada inferencia, la temperatura durante la corrida y las versiones exactas de cada entorno— están en crtdrops.mx/datos/round1, para que los revises o los compares con los tuyos.
Lo que este resultado no dice
Esto es una medición, no una sentencia sobre OpenVINO. Vale para lo que se midió, y nada más:
- Un equipo. Un N100. En un procesador con FP16 nativo, o con las instrucciones de matrices de los Xeon, la historia puede ser otra.
- Sólo la CPU. El N100 tiene una gráfica integrada, y OpenVINO sabe usarla. No la medí.
- Batch 1, latencia. OpenVINO tiene un modo pensado para procesar muchas entradas a la vez, con varios flujos en paralelo. Tampoco lo medí.
- Tres modelos, en f32. Con precisión reducida, o con la cuantización propia de OpenVINO, los números cambian.
Lo que sí dice es más modesto y, creo, más útil: en este equipo y con esta configuración, la ventaja que uno esperaría no apareció.
Las preguntas que dejé abiertas, medidas
El 7 de octubre volví al N100, recién reiniciado, con tres de esas preguntas: si ahí también bajaba la precisión por su cuenta, si su modo de muchas entradas a la vez cerraba la diferencia, y qué hacía la gráfica integrada.
En la CPU del N100, no baja la precisión. Compilados sin pedir nada, los tres modelos quedaron en f32. No es mérito de OpenVINO: ese procesador no tiene FP16, así que no hay a dónde bajar. En la Mac sí bajó porque su procesador sí lo tiene. La guardia sigue haciendo falta en cuanto cambias de equipo.
Muchas entradas a la vez no cierra la diferencia. En su modo para procesar varias peticiones en paralelo, OpenVINO abre dos flujos en el N100 y gana entre 4 y 9 %. Comparando lo mejor de cada uno —ese modo contra ONNX Runtime con cuatro procesos—, ONNX Runtime sigue adelante entre 14 y 20 %.
En la gráfica integrada, OpenVINO sí gana. En FP16. La gráfica del N100 sí trabaja en FP16, y OpenVINO la usa en esa precisión sin que nadie lo pida: la misma trampa del ensayo, ahora en el N100. Así, YOLO26n pasa de 17.8 inferencias por segundo con ONNX Runtime a 24.7, un 39 % más; ResNet18, de 43.4 a 55.9. Con la precisión fijada en f32, la gráfica no gana nada: 16.3 y 37.2. Y MobileNetV2 es más lento en la gráfica que en la CPU, en cualquier precisión.
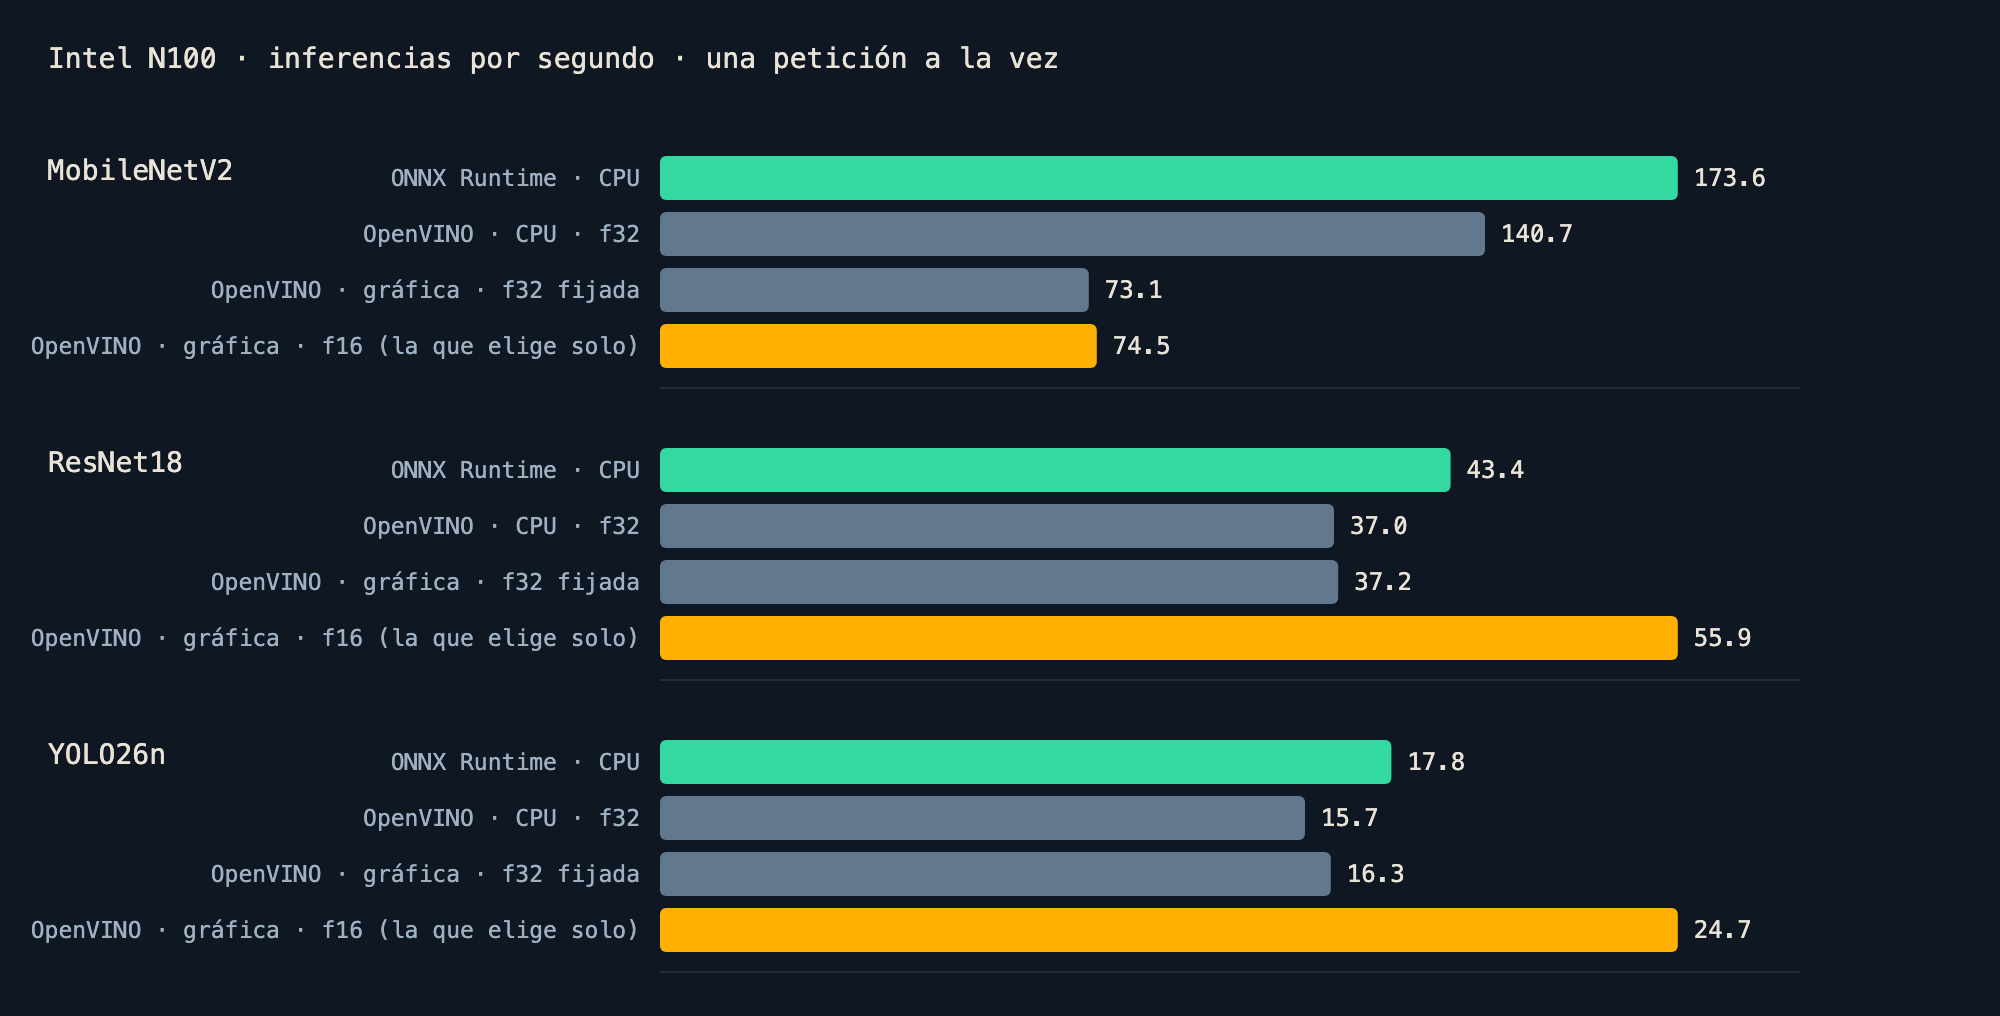
¿Y da lo mismo? Lo comprobé como la Round 1: las doce imágenes reales, contra la salida de referencia, con las mismas tolerancias. Los dos clasificadores dan la misma clase en las doce. YOLO26n pasa la validación —pide 95 % de coincidencia y obtuvo 96.6 %—, pero no es igual: encontró los mismos objetos con menos confianza. En una imagen, una persona bajó de 0.829 a 0.696; en otra, unos esquís, de 0.468 a 0.376. Si tu sistema sólo acepta detecciones arriba de 0.7, esa persona desaparece en la gráfica y no en la CPU.
Es la lección de esta nota otra vez, en otro hardware: pasar la validación no prueba que nada cambió. La ventaja de la gráfica es real, y viene con un cambio de precisión que hay que decidir a sabiendas, no descubrir después.
Y los números se repiten. Las medidas en CPU, tomadas en tres días distintos, cambiaron menos de 3 % de una vez a otra. Los datos de esta parte están en crtdrops.mx/datos.
Lo que haría distinto al comparar runtimes
Si estás eligiendo runtime para un equipo de edge, cuatro cosas que habría hecho desde el principio:
Fija la precisión, y lee la que quedó. No la que pediste: la que el runtime eligió después de compilar. Son dos líneas de código, y son la diferencia entre comparar runtimes y comparar precisiones.
No uses la exactitud como prueba de que la comparación es justa. Que las salidas coincidan dice que el cambio no se notó en ese modelo. No dice que no haya cambio.
Escribe antes qué esperas. Aunque la respuesta sea no lo sé. Si no lo escribes, cualquier resultado parece confirmar lo que ya pensabas.
Mide en el equipo, no en tu máquina. Recién reiniciado, con calentamiento, y con p50 y p95, no con un promedio. La Mac me sirvió para encontrar el problema; la respuesta sólo la dio el N100.
La guardia, en código
Esto es lo que uso ahora para que no se me vuelva a pasar. Compila el modelo pidiendo una precisión, lee la que de verdad quedó y, si no es la misma, se niega:
import openvino as ov


class PrecisionMismatch(RuntimeError):
    """The compiled model runs in a precision other than the one requested."""


def effective_precision(compiled: ov.CompiledModel) -> str:
    return compiled.get_property("INFERENCE_PRECISION_HINT").get_type_name()


def compile_pinned(model, device="CPU", precision="f32", core=None, **config):
    core = core or ov.Core()
    compiled = core.compile_model(model, device, {"INFERENCE_PRECISION_HINT": precision, **config})
    got = effective_precision(compiled)
    if got != precision:
        raise PrecisionMismatch(f"asked for {precision} on {device}, the compiled model uses {got}")
    return compiled
Con OpenVINO 2026.4.0 en una Mac con Apple M5 Pro, compilar el MobileNetV2 sin
pedir nada da f16; con compile_pinned da f32. Y si algún día no lo da, la
medición se detiene en vez de seguir con otra precisión. Sirve igual para la
gráfica integrada (device="GPU"), donde OpenVINO usa FP16 por omisión.
La tabla completa —cinco modelos en una Raspberry Pi 5 y en el N100, con ONNX Runtime y OpenVINO— está en crtdrops.mx, junto a una revisión de modelos ONNX que corre en tu navegador sin subir el archivo a ninguna parte. Si abres uno de los modelos que medí, la herramienta lo reconoce y te enseña sus números.
Medir tu propio modelo así, en los dos equipos y con el mismo protocolo, ya se puede: está en la misma sección, por 149 USD, con un reporte de muestra para que veas qué recibes.
crtdrops.mx — crtdrops.mx/modelo/
Actualizada el 5 de octubre de 2026 con la distribución completa, los datos crudos y el código de la guardia, y el 7 de octubre con las preguntas que quedaban abiertas, medidas en el N100.
Israel Negrete Lepe es ingeniero en electrónica. Veinticinco años haciendo que sistemas distintos funcionen juntos en condiciones reales: del sensor, el vehículo o la transacción al backend, los datos, la seguridad y la operación. Hoy, cada vez más, IA en el borde. Acepto proyectos por hora o por entrega: israel0negrete@gmail.com.